Capitulo 07
SQL analítico avanzado e ingeniería de features
Ventanas, granularidad y datos relacionales para construir señales de negocio confiables
Construye análisis por fila y por segmento con funciones de ventana, CTE, JOIN y JSON; aprende a preservar granularidad y a convertir eventos transaccionales en features RFM reproducibles.
El grano responde: «¿qué representa una fila de esta tabla o etapa?». Si no lo declaras, un JOIN, una agregación o una ventana puede duplicar ventas y producir features incorrectas sin dar ningún error.
Agrega en el nivel correcto; usa ventanas cuando necesites comparar cada fila con su grupo sin perder el detalle.
— Regla de SQL analítico
7.1 Qué aprenderás y cómo conecta
Este capítulo completa el Módulo 8 del PDF: SQL Analítico Avanzado. Al terminar podrás:
- Distinguir una agregación que colapsa filas de una función de ventana que conserva el detalle.
- Elegir
PARTITION BY,ORDER BYy el marco de ventana adecuados. - Usar
ROW_NUMBER,RANK,LAG, sumas acumuladas y agregaciones por segmento. - Unir tablas sin multiplicar registros accidentalmente.
- Leer JSON con funciones propias del motor SQL.
- Diseñar features con una definición de negocio, una fecha de corte y una granularidad explícitas.
En M6: SQL y DuckDB aprendiste a filtrar, agrupar y consultar archivos. Aquí añadimos contexto entre filas y relaciones entre tablas. El siguiente capítulo, M8, lleva las tablas validadas a persistencia y automatización.
7.2 GROUP BY versus funciones de ventana
GROUP BY reduce cada grupo a una fila. Una función de ventana calcula sobre filas relacionadas, pero deja una salida por cada fila de entrada.
| Necesidad | Herramienta | Filas de salida |
|---|---|---|
| Total vendido por cliente | GROUP BY cliente_id | Una por cliente |
| Cada compra y el total histórico del cliente | SUM(...) OVER (PARTITION BY cliente_id) | Una por compra |
| Posición de cada compra dentro del cliente | ROW_NUMBER() OVER (...) | Una por compra |
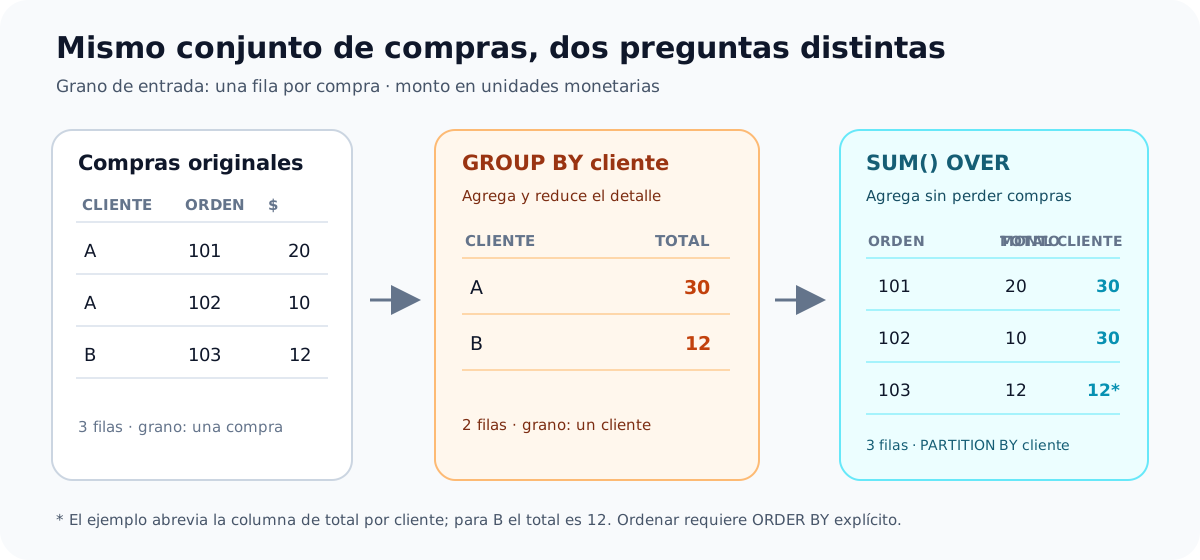
GROUP BY responde una fila por cliente; la ventana conserva el detalle de cada orden. Datos esquemáticos.Supongamos orders(order_id, customer_id, order_date, amount). Esta consulta conserva cada compra y agrega su contexto:
SELECT
    order_id,
    customer_id,
    order_date,
    amount,
    SUM(amount) OVER (
        PARTITION BY customer_id
    ) AS customer_lifetime_value,
    ROW_NUMBER() OVER (
        PARTITION BY customer_id
        ORDER BY order_date, order_id
    ) AS purchase_number
FROM orders;
La cláusula OVER define la ventana:
PARTITION BYreinicia el cálculo para cada grupo; no ordena la salida final.ORDER BYestablece el orden lógico dentro de cada grupo. Agrega una segunda clave estable para resolver empates.- El marco, por ejemplo
ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW, define qué filas ordenadas entran en el cálculo.
Ranking y acumulados
ROW_NUMBER() asigna una posición única; RANK() comparte la posición en empates y deja saltos; DENSE_RANK() comparte la posición sin saltos.
SELECT
    customer_id,
    order_date,
    amount,
    RANK() OVER (
        PARTITION BY customer_id
        ORDER BY amount DESC
    ) AS rank_by_amount,
    SUM(amount) OVER (
        PARTITION BY customer_id
        ORDER BY order_date, order_id
        ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
    ) AS cumulative_spend
FROM orders;
El marco explícito evita ambigüedad entre filas que comparten la misma fecha. Para una serie temporal, LAG y LEAD comparan con la observación anterior o siguiente:
SELECT
    customer_id,
    order_date,
    amount,
    LAG(amount) OVER (
        PARTITION BY customer_id
        ORDER BY order_date, order_id
    ) AS previous_order_amount
FROM orders;
La primera compra de cada cliente no tiene una compra anterior: previous_order_amount será NULL. Ese NULL significa «no existe antecedente», no cero.
7.3 CTE y granularidad: formar features sin inflar el total
Un CTE (Common Table Expression) nombra una etapa de una consulta con WITH. Sirve para que cada transformación exprese una sola idea y deje claro el grano que recibe y entrega.
Ejemplo: construir RFM por cliente a partir de órdenes y catálogo. La tabla orders tiene una fila por línea de pedido; products debe tener una fila por producto.
WITH order_lines AS (
    SELECT
        o.order_id,
        o.customer_id,
        CAST(o.order_date AS DATE) AS order_date,
        o.quantity * p.unit_price AS line_amount
    FROM orders AS o
    JOIN products AS p
      ON p.product_id = o.product_id
    WHERE o.order_date >= DATE '2024-01-01'
      AND o.order_date <  DATE '2025-01-01'
),
rfm AS (
    SELECT
        customer_id,
        MAX(order_date) AS last_order_date,
        COUNT(DISTINCT order_id) AS frequency,
        SUM(line_amount) AS monetary
    FROM order_lines
    GROUP BY customer_id
),
scored AS (
    SELECT
        customer_id,
        DATE_DIFF('day', last_order_date, DATE '2025-01-01') AS recency_days,
        frequency,
        monetary
    FROM rfm
)
SELECT
    customer_id,
    recency_days,
    frequency,
    monetary,
    DENSE_RANK() OVER (ORDER BY monetary DESC) AS spend_rank,
    SUM(monetary) OVER (
        ORDER BY monetary DESC, customer_id
        ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
    ) AS cumulative_spend
FROM scored
ORDER BY spend_rank, customer_id;
Este ejemplo usa sintaxis de DuckDB para DATE_DIFF. En otros motores cambia la función de fechas, no la definición de RFM:
- Recency: días desde la última actividad hasta una fecha de corte conocida.
- Frequency: número de compras en una ventana temporal declarada.
- Monetary: valor monetario en esa misma ventana y moneda.
La fecha de corte no debe ser «hoy» si quieres reproducir un análisis histórico. Guárdala como parámetro y documenta si frequency cuenta órdenes, líneas o días activos.
El error silencioso: un JOIN uno-a-muchos
Si una orden contiene tres líneas, al unir orders con order_lines la fila de orden aparece tres veces. Sumar después un total a nivel orden lo triplica. Antes de combinar tablas, escribe sus granos:
orders:       una fila por order_id
order_lines:  una fila por order_id + product_id
customers:    una fila por customer_id
Agrega primero al grano del consumidor o conserva los campos de detalle; no asumas que un JOIN preserva el número de filas. Usa COUNT(DISTINCT ...) solo cuando la unidad de negocio realmente sea esa entidad: no como parche para una relación mal definida.
Comprueba cardinalidades antes y después de cada unión. Una dimensión que debería ser única por product_id pero tiene duplicados multiplica importes y altera cualquier feature posterior.
7.4 JSON en SQL
Una API puede devolver datos semi-estructurados, por ejemplo:
{"order_id": 81, "customer": {"id": "C-17"}, "items": [{"sku": "A2", "qty": 2}]}JSON es útil en la zona de ingesta porque conserva campos variables; para análisis repetible conviene extraer los atributos que tienen significado y contrato claros. Las funciones exactas varían por motor:
-- DuckDB
SELECT
    json_extract_string(payload, '$.customer.id') AS customer_id,
    CAST(json_extract(payload, '$.order_id') AS INTEGER) AS order_id
FROM raw_events;
-- SQLite con su extensión JSON1
SELECT
json_extract(payload, '$.customer.id') AS customer_id,
json_extract(payload, '$.order_id') AS order_id
FROM raw_events;Antes de castear, valida que el atributo exista y tenga el formato esperado. Para listas como items, decide si necesitas conservar el documento original o normalizar cada elemento a una fila relacionada. No mezcles en la misma columna el dato raw y una interpretación transformada.
7.5 De la consulta a una feature utilizable
Una buena feature no es solo una columna calculada. Debe incluir:
- Unidad de observación: por ejemplo, un cliente al cierre de cada mes.
- Ventana temporal: compras de los 90 días anteriores a ese cierre.
- Fecha de corte: la información disponible antes de predecir.
- Regla para ausencias: cliente sin compras tiene frecuencia 0; recency puede ser desconocida o codificarse por una regla explícita.
- Prueba: comprobar una muestra a mano y que no existan duplicados en la llave esperada.
-- Una fila de salida por cliente y mes de corte.
SELECT
    customer_id,
    DATE_TRUNC('month', order_date) AS month,
    COUNT(DISTINCT order_id) AS orders_in_month,
    SUM(line_amount) AS spend_in_month
FROM order_lines
WHERE order_date >= DATE '2024-01-01'
  AND order_date <  DATE '2025-01-01'
GROUP BY customer_id, DATE_TRUNC('month', order_date);
Para ML, evita incorporar eventos posteriores al momento de predicción. Si el target pregunta si habrá churn en los próximos 30 días, las features deben construirse solo con información disponible antes de ese horizonte. La fuga temporal puede ocurrir incluso en una consulta SQL que «corre bien».
Función de ventana
M7Cálculo sobre filas relacionadas que conserva una fila de salida por cada fila de entrada, a diferencia de GROUP BY.
Ej: SUM(amount) OVER (PARTITION BY customer_id ORDER BY order_date) calcula el acumulado por cliente sin colapsar las compras.
7.6 Errores comunes y lista de revisión
Usa las tablas de usuarios, órdenes y productos de una tienda. Construye una fila por usuario que incluya recency, frequency, monetary, ranking por gasto y tendencia entre períodos. Incluye usuarios sin compras, prueba las cardinalidades, fija un corte temporal y compara tres resultados con un cálculo manual. Explica qué decisión podría apoyar cada feature y qué no permite concluir.
💡 Cuenta cuántas filas corresponden al grano de entrada.
Q: ¿Cómo detectarías que un JOIN infló los ingresos?
Declararía la granularidad de ambas fuentes, verificaría unicidad de las claves y compararía conteos y sumas antes y después. Revisaría específicamente relaciones uno-a-muchos y agregaría al grano correcto antes de unir si la métrica lo requiere.
🪤 Aplicar DISTINCT al total sin entender qué relación produjo los duplicados.Para continuar
Las features analíticas solo son útiles si sobreviven a la ejecución y se pueden regenerar. En M8 conectarás contratos, validaciones, transacciones e idempotencia para llevar ese resultado a una capa persistente.
Tu espacio de estudio
Notas privadas
Se guardan solo en este navegador y no se publican.