Capitulo 14
Distribuciones categóricas, outliers y pruebas
Resume grupos con contexto y contrasta hipótesis sin convertir un p-valor en veredicto
Resume y visualiza variables categóricas, investiga extremos numéricos, usa transformaciones univariadas con sentido y selecciona pruebas paramétricas o no paramétricas según el diseño y los supuestos.
El p-valor no es la probabilidad de que la hipótesis nula sea verdadera ni mide importancia práctica. Interpreta la prueba junto con diseño, tamaño de efecto, incertidumbre y consecuencias de la decisión.
Resume antes de contrastar; valida los supuestos antes de confiar en el número.
— Principio de estadística aplicada
14.1 Categorías: conteos, proporciones y orden
Una variable categórica etiqueta observaciones en grupos. Puede ser nominal (canal, región), ordinal (nivel de satisfacción) o binaria (sí/no). Antes de resumirla, comprueba categorías escritas de varias formas, valores desconocidos y tamaños de grupo.
Este capítulo corresponde al Módulo 15 del PDF: Visualización de variables categóricas, incluyendo sus temas de distribuciones, extremos y pruebas.
import pandas as pd

counts = df["contract"].value_counts(dropna=False)
summary = pd.DataFrame({
    "customers": counts,
    "share": counts / len(df),
})
print(summary)
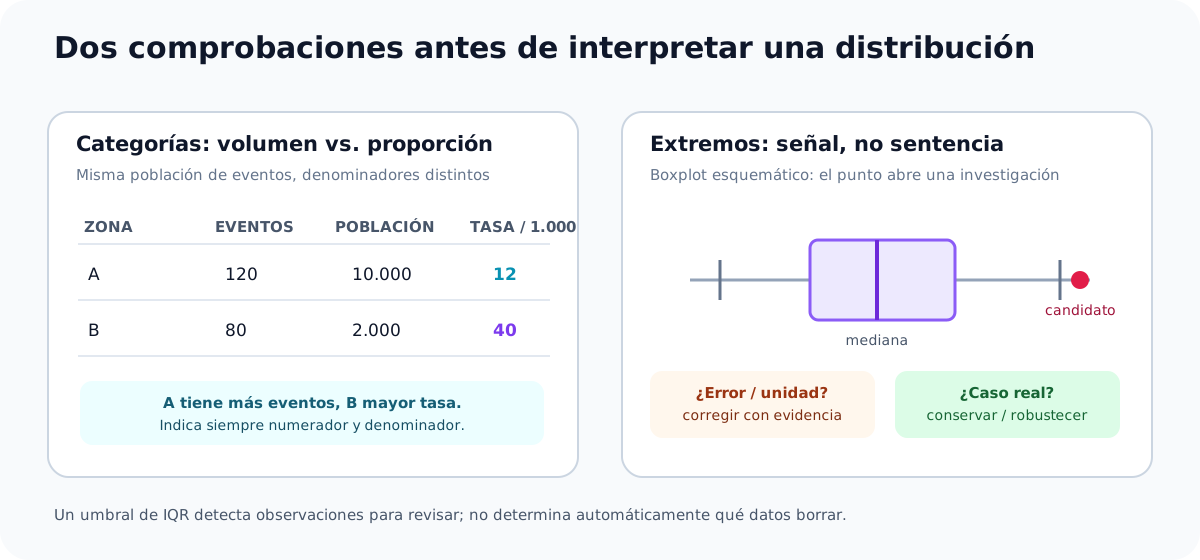
Los conteos responden «¿cuántos?»; la proporción responde «¿qué parte del total?». Para comparar regiones o períodos de tamaño diferente, normalmente necesitas proporciones o tasas además de conteos. Indica el denominador y evita ocultar grupos pequeños en porcentajes llamativos.
import seaborn as sns
import matplotlib.pyplot as plt

order = df["contract"].value_counts().index
ax = sns.countplot(data=df, y="contract", order=order, color="#087e8b")
ax.set(title="Clientes por tipo de contrato", xlabel="Clientes", ylabel="Contrato")
plt.tight_layout()
plt.show()
Para comparar tasas por grupo, agrega explícitamente numerador y denominador:
rates = (
    df.groupby("contract", as_index=False)
      .agg(churned=("churn", "sum"), customers=("churn", "size"))
)
rates["churn_rate"] = rates["churned"] / rates["customers"]
No mezcles una categoría «desconocida» con una categoría real. Decide si el nulo es una clase informativa y presenta ambas opciones en la exploración.
14.2 Outliers y transformaciones univariadas
Los extremos afectan de forma distinta a media, mediana, varianza, mínimos/máximos y modelos. Para detectarlos, combina histograma, boxplot, percentiles y reglas de dominio; un umbral automático es una alarma, no una orden de borrado.
El logaritmo puede reducir asimetría positiva en variables no negativas, como monto de compra. log1p(x) calcula log(1+x) y permite ceros. No aplica directamente a valores negativos; para datos con signos puede evaluarse una transformación Yeo–Johnson.
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt

if (df["purchase_amount"].dropna() < 0).any():
    raise ValueError("log1p requiere valores no negativos en este ejemplo")

df["log_purchase_amount"] = np.log1p(df["purchase_amount"])
fig, axes = plt.subplots(1, 2, figsize=(10, 4))
sns.histplot(df["purchase_amount"], ax=axes[0])
axes[0].set(title="Monto original", xlabel="Monto")
sns.histplot(df["log_purchase_amount"], ax=axes[1])
axes[1].set(title="log(1 + monto)", xlabel="log1p(monto)")
plt.tight_layout()
plt.show()
La transformación cambia la escala y la interpretación de diferencias. No la uses solo para que el gráfico parezca «normal». En inferencia, explica la escala transformada; en ML, ajusta transformaciones que aprenden parámetros dentro del pipeline del fold.
14.3 Hipótesis, significancia y supuestos
Un contraste formal comienza con:
- Hipótesis nula (
H₀): patrón o diferencia que se compara con los datos. - Alternativa (
H₁): diferencia o asociación relevante según la pregunta. - Nivel
α: umbral de error tipo I elegido antes del análisis; por convención se ve 0.05, pero no es universal. - Estadístico y p-valor: resumen del grado de compatibilidad entre los datos y
H₀bajo los supuestos del modelo.
Un p-valor pequeño no mide tamaño del efecto ni probabilidad de que H₀ sea cierta. Un p-valor grande tampoco prueba igualdad. Considera potencia, tamaño muestral, sesgo de selección, intervalos de confianza y relevancia práctica.
Elegir una prueba según el diseño
| Pregunta y datos | Posible prueba | Supuestos / cuidado |
|---|---|---|
| Comparar medias de dos grupos independientes | t de Welch | Observaciones independientes; distribución de la media suficientemente estable |
| Comparar dos grupos independientes con fuerte asimetría/ordinal | Mann–Whitney U | Compara rangos; no siempre es una prueba de igualdad de medianas |
| Comparar más de dos grupos independientes | ANOVA de Welch o Kruskal–Wallis | Múltiples comparaciones requieren ajuste y contexto |
| Asociación entre dos variables categóricas | Chi-cuadrado de independencia | Frecuencias esperadas adecuadas; si son pequeñas, considera prueba exacta |
| Dos mediciones pareadas | t pareada o Wilcoxon de rangos con signo | Las filas deben estar emparejadas por sujeto/unidad |
No elijas una prueba solo porque los datos «no parecen normales». Pregunta cómo se muestrearon, si los grupos son independientes, cuál es la unidad estadística y qué hipótesis práctica se quiere contrastar.
from scipy.stats import mannwhitneyu

monthly = df.loc[df["contract"] == "Monthly", "monthly_charges"].dropna()
annual = df.loc[df["contract"] == "Annual", "monthly_charges"].dropna()

result = mannwhitneyu(monthly, annual, alternative="two-sided")
print("U:", result.statistic, "p:", result.pvalue)
El código calcula una prueba; no determina si la diferencia importa ni controla variables de confusión. Acompáñala con distribuciones, tamaños de grupo y una medida de efecto apropiada.
Muchas pruebas
Si pruebas cientos de variables y reportas solo las que dan p < 0.05, aumentan los falsos positivos. Define hipótesis antes del análisis cuando sea posible, reporta todas las pruebas relevantes y considera ajustes como Benjamini–Hochberg para controlar la tasa de descubrimientos falsos.
p-valor
M14Probabilidad, bajo la hipótesis nula y los supuestos del modelo, de observar un estadístico al menos tan extremo como el obtenido.
Ej: Un p-valor de 0.03 no significa que haya 3 % de probabilidad de que H₀ sea verdadera ni que el efecto tenga importancia comercial.
14.4 Ruta de análisis para una comparación
- Especifica variable, grupos, unidad de análisis y periodo.
- Resume conteos, nulos y tamaños de grupo.
- Grafica distribuciones y valores extremos; confirma que cada fila es independiente o define pares/grupos.
- Escribe
H₀,H₁,αy la métrica de efecto antes de leer el resultado. - Comprueba supuestos y selecciona una prueba compatible.
- Reporta estadístico, p-valor, tamaño de efecto, incertidumbre y limitaciones.
- Si tomas una decisión, conecta la regla con costos y evidencia adicional.
Con los datos de clientes, visualiza conteos y proporciones de churn por contrato, reporta tamaño de cada grupo y faltantes y formula una hipótesis antes del test. Decide si la unidad es independiente, selecciona una prueba para proporciones o distribuciones compatible con la pregunta, calcula una medida de efecto e interpreta el resultado sin inferir causalidad. Repite la visualización tras excluir y conservar categorías desconocidas, explicando el cambio.
💡 La interpretación está condicionada a H₀ y sus supuestos.
Q: ¿Qué revisarías antes de usar una prueba no paramétrica?
Definiría la unidad y el diseño, verificaría independencia o emparejamiento, entendería qué compara el estadístico (rangos o distribuciones) y reportaría efecto, incertidumbre y limitaciones; no la elegiría como sustituto automático de revisar los supuestos.
🪤 Afirmar que Mann–Whitney siempre compara medianas y nunca requiere supuestos.Para continuar
M14 compara distribuciones y grupos. En M15 estudiarás asociaciones entre variables y cómo la colinealidad puede volver inestables las explicaciones de un modelo.
Tu espacio de estudio
Notas privadas
Se guardan solo en este navegador y no se publican.