Capitulo 10
ML Lab II: modelado y métricas
De una línea y una probabilidad a una decisión evaluada con validación y costos de error
Entiende regresión lineal y logística, funciones de pérdida y ensembles; interpreta matriz de confusión, precision, recall, F1 y ROC-AUC; valida con cross-validation y ajusta hiperparámetros sin contaminar el test final.
La métrica resume cierto comportamiento del modelo; la decisión define qué errores son aceptables y cuánto cuesta cada uno. Selecciona el modelo después de acordar esa relación con quien usará sus predicciones.
Elige la métrica desde el costo del error; elige el umbral desde la capacidad de actuar.
— Regla de evaluación
10.1 Qué aprenderás
Este capítulo corresponde al Módulo 11 del PDF: ML Lab II. Al terminar podrás:
- Explicar qué aproxima una regresión lineal y cómo la logística convierte un score en probabilidad.
- Entender pérdida, ajuste y regularización a nivel conceptual.
- Comparar árboles ensamblados por bagging, boosting y stacking.
- Elegir e interpretar métricas de clasificación según el problema.
- Separar train, validación y test; usar validación cruzada y
GridSearchCVde forma segura. - Reportar incertidumbre, límites y costos, no solo una cifra atractiva.
El preprocesamiento está en M9. El ejemplo conductor es churn de telecomunicaciones: queremos identificar clientes que podrían cancelar para evaluar acciones de retención, no etiquetar personas como «malos clientes».
10.2 Regresión lineal y logística: dos tareas distintas
Regresión lineal
Para una respuesta numérica continua, la regresión lineal aproxima una combinación de variables:
ŷ = β₀ + β₁x₁ + β₂x₂ + ... + βₚxₚβ₀ es el intercepto; cada βⱼ expresa cómo cambia la predicción al variar xⱼ una unidad, manteniendo las demás constantes, bajo las limitaciones del modelo. El ajuste busca reducir errores (habitualmente, suma de cuadrados). Un valor extremo puede dominar el error cuadrático; por eso evalúa residuos y considera MAE/RMSE según el costo de equivocarse.
Regresión logística
Aunque se llame «regresión», la logística se usa para clasificación. Calcula un score lineal y lo transforma con la función sigmoide en una probabilidad entre 0 y 1:
z = β₀ + β₁x₁ + ... + βₚxₚ
P(y = 1 | x) = 1 / (1 + e^(−z))
El clasificador compara esa probabilidad con un umbral. El 0.5 predeterminado es una convención, no una ley. El entrenamiento suele minimizar log-loss (binary cross-entropy), que penaliza con fuerza predicciones seguras pero incorrectas. La regularización controla coeficientes grandes y ayuda a reducir sobreajuste; su fuerza se ajusta como hiperparámetro.
10.3 Ensembles: juntar modelos con una estrategia
| Familia | Idea | Ejemplo | Cuidado |
|---|---|---|---|
| Bagging | Entrenar modelos en muestras bootstrap y combinar resultados para reducir varianza | Random Forest | Pierde algo de simplicidad interpretativa; revisar profundidad y balance |
| Boosting | Entrenar secuencialmente, dando atención a errores previos | Gradient Boosting, HistGradientBoosting | Puede sobreajustar si la tasa, profundidad o rondas no se controlan |
| Stacking | Combinar predicciones de modelos base mediante un meta-modelo | Logística sobre probabilidades de bosque y boosting | El meta-modelo debe entrenarse con predicciones out-of-fold, no con predicciones sobre el mismo train |
Más complejidad no garantiza mejor generalización. Empieza con un baseline y una regresión logística; añade un ensemble solo si mejora una métrica relevante en validación y el costo operativo se justifica.
10.4 Matriz de confusión: contar el tipo de error
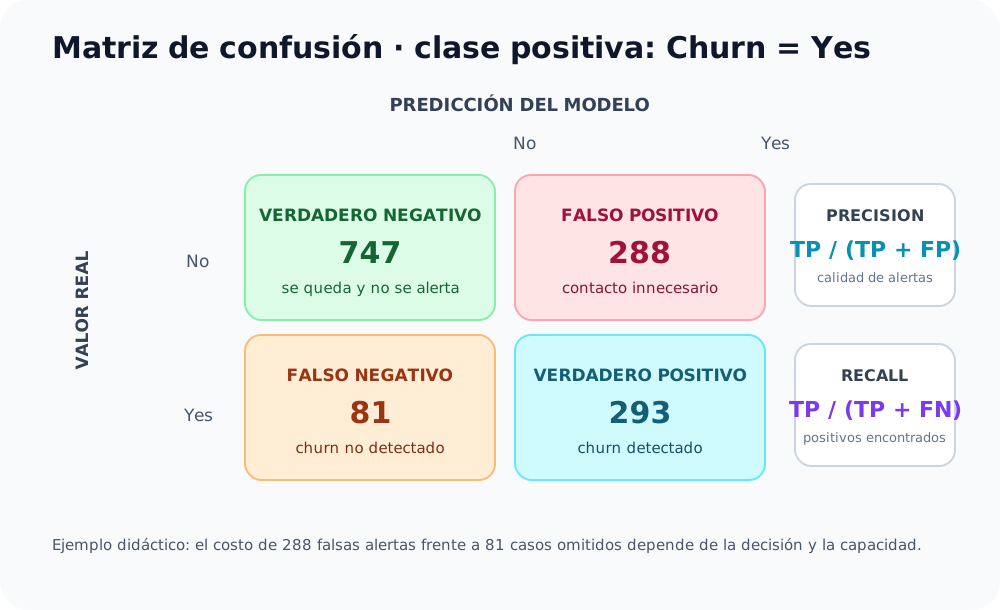
Para una clase positiva Churn=Yes:
| Predijo No | Predijo Yes | |
|---|---|---|
| Real No | Verdadero negativo (TN) | Falso positivo (FP) |
| Real Yes | Falso negativo (FN) | Verdadero positivo (TP) |
- Accuracy:
(TP + TN) / total; puede engañar si una clase domina. - Precision:
TP / (TP + FP); de los clientes que marcaré, ¿cuántos cancelan? - Recall:
TP / (TP + FN); de quienes cancelan, ¿a cuántos detecto? - F1: media armónica de precision y recall; no incorpora por sí sola el costo monetario.
- ROC-AUC: capacidad de ordenar positivos por encima de negativos a través de umbrales; no informa calibración ni el costo operativo en un punto concreto.
Si una acción de retención cuesta dinero, un falso positivo puede ser una llamada innecesaria. Un falso negativo puede significar perder un cliente. El umbral apropiado depende de esos costos, de la capacidad de contacto y de políticas éticas de uso.
from sklearn.metrics import (
    ConfusionMatrixDisplay,
    classification_report,
    roc_auc_score,
)

probabilidades = modelo.predict_proba(X_test)[:, 1]
umbral = 0.40  # elegir con validación y capacidad operativa, no con test
predicciones = (probabilidades >= umbral).astype(int)

print(classification_report(y_test, predicciones, zero_division=0))
print("ROC-AUC:", roc_auc_score(y_test, probabilidades))
ConfusionMatrixDisplay.from_predictions(y_test, predicciones)
roc_auc_score recibe scores/probabilidades, no las etiquetas binarias obtenidas tras aplicar el umbral. Ajusta el umbral en validación. El test se mantiene intacto hasta la decisión final.
10.5 Validación cruzada y búsqueda de hiperparámetros
Una partición puede ser afortunada o desfavorable. La validación cruzada divide el conjunto de desarrollo en folds: cada fold sirve una vez como validación y el resto como entrenamiento. El promedio estima desempeño y la variación entre folds muestra estabilidad.
Para datos independientes e i.i.d. puede usarse StratifiedKFold en clasificación. Para series temporales, entidades repetidas o grupos relacionados, usa una estrategia que respete tiempo o grupos; un split aleatorio podría filtrar información.
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import GridSearchCV, StratifiedKFold
from sklearn.pipeline import Pipeline

# `preprocessor` viene de M9 y está dentro del estimador evaluado.
pipeline = Pipeline([
    ("preprocesamiento", preprocessor),
    ("modelo", LogisticRegression(class_weight="balanced", max_iter=2000)),
])

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
search = GridSearchCV(
    estimator=pipeline,
    param_grid={"modelo__C": [0.01, 0.1, 1.0, 10.0]},
    scoring="recall",
    cv=cv,
    n_jobs=-1,
    refit=True,
)
search.fit(X_train, y_train)
best_model = search.best_estimator_
La búsqueda recibe X_train y y_train; el preprocesador se reajusta dentro de cada fold, evitando fuga. El test no participa en la selección. C controla la regularización inversamente: valores más pequeños implican regularización más fuerte.
Si exploras muchos modelos, múltiples métricas y umbrales, puedes sobreajustar también el proceso de selección. Limita búsquedas, registra decisiones y reserva una evaluación final. Para estudios de alto impacto, considera validación anidada y análisis de incertidumbre.
10.6 Ejemplo de churn y lectura honesta de resultados
La pre-entrega local trabaja con Telco Customer Churn, 7.043 clientes, split estratificado 80/20 y Regresión Logística con pesos balanceados. Los resultados registrados son:
| Métrica | Resultado |
|---|---|
| Accuracy | 0.738 |
Precision (Churn=Yes) | 0.504 |
Recall (Churn=Yes) | 0.783 |
F1 (Churn=Yes) | 0.614 |
La matriz [[747, 288], [81, 293]] usa filas reales (No, Yes) y columnas predichas (No, Yes). El modelo detectó 293 abandonos, dejó 81 sin detectar y marcó 288 clientes que permanecieron. Ese recall relativamente alto tiene un costo: muchas alertas resultan falsas. No es «mejor» o «peor» sin comparar el costo de las acciones y una alternativa baseline.
Estos números pertenecen a una ejecución didáctica concreta. No prueban que el modelo funcione igual en otra muestra, población, momento ni decisión real. La fecha de corte y el horizonte de churn forman parte de la definición del target.
Recall
M10Proporción de casos positivos reales que el clasificador identifica: TP / (TP + FN).
Ej: Un recall de 0.783 para churn significa que el modelo encontró cerca del 78.3 % de los abandonos del conjunto evaluado; no dice cuántas alertas fueron correctas.
10.7 Mejores prácticas antes de aceptar un modelo
Parte de las probabilidades del modelo de churn. En el conjunto de validación compara umbrales entre 0.20 y 0.80; para cada uno calcula TP, FP, FN, precision, recall y el número de clientes que el equipo podría contactar. Define costos ilustrativos para contacto y abandono, selecciona una regla defendible y evalúala una vez en test. Explica qué decisión cambiaría si la capacidad de contacto se reduce a la mitad.
💡 Cada fold debe aprender su propia mediana y sus propias categorías.
Q: ¿Cómo explicarías un modelo con recall alto y precision baja?
Detecta muchos positivos reales, pero también genera muchas alertas falsas. Es útil cuando omitir positivos cuesta más que revisar alertas, siempre que exista capacidad de actuación y que el costo esté aceptado por el negocio.
🪤 Afirmar que recall alto significa que la mayoría de las alertas son correctas; eso lo describe precision.Para continuar
Ya sabes medir el comportamiento de un modelo. M11 cambia de escala: aprenderás a convertir datos y métricas en visuales legibles que ayuden a una persona a entender una decisión.
Tu espacio de estudio
Notas privadas
Se guardan solo en este navegador y no se publican.