Capitulo 09
ML Lab I: exploración, preprocesamiento y pipelines
Del diagnóstico del dataset a una transformación reproducible, ajustada sin fuga de información
Explora calidad, distribuciones y relaciones; decide cómo tratar faltantes y extremos; usa PCA con criterio y construye transformadores y pipelines de Scikit-Learn que aprenden solo de train.
Un valor ausente puede ser un error de captura, una respuesta no aplicable o una señal del proceso. Imputarlo sin investigar puede esconder un patrón importante. El preprocesamiento empieza como trabajo de dominio y termina como transformación reproducible.
Explora con todos los datos permitidos; aprende parámetros de transformación solo con entrenamiento.
— Principio de preprocesamiento
9.1 Mapa: de datos crudos a una matriz para el modelo
Este capítulo corresponde al Módulo 10 del PDF: ML Lab I. Al terminar podrás:
- Auditar filas, tipos, nulos, duplicados, rangos y distribuciones.
- Diferenciar patrones de ausencia y escoger una estrategia justificable.
- Investigar outliers sin borrarlos automáticamente.
- Leer relaciones con gráficos univariados y multivariados.
- Aplicar escalado y PCA sin fuga de información.
- Crear features y transformadores reutilizables.
- Encadenar imputación, codificación, escalado y transformaciones con
PipelineyColumnTransformer.
La preparación inicial y la división train/test aparecieron en M3. Aquí profundizamos las decisiones. El entrenamiento y la elección de métricas se trabajan en M10: ML Lab II.
9.2 EDA: diagnosticar antes de transformar
Un análisis exploratorio de datos (EDA) no es una galería de gráficos. Es una secuencia de preguntas para decidir si los datos pueden responder el problema:
- ¿Qué representa una fila y cuál es el período cubierto?
- ¿Qué columnas son identificadores, mediciones, categorías, fechas o target?
- ¿Hay duplicados, valores imposibles o unidades mezcladas?
- ¿Cómo se distribuyen las variables? ¿Qué relaciones parecen relevantes?
- ¿Los grupos de entrenamiento y evaluación reflejan el proceso real de uso?
import pandas as pd

df = pd.read_csv("data/clientes.csv")
if "TotalCharges" in df.columns:
    df["TotalCharges"] = pd.to_numeric(df["TotalCharges"], errors="coerce")  # formato Telco: vacíos pasan a NaN

print(df.shape)
print(df.dtypes)
print(df.isna().mean().sort_values(ascending=False).head(10))
print(df.nunique(dropna=False).sort_values().head(10))
print(df.describe(include="all").T)
print("Duplicados exactos:", df.duplicated().sum())
El perfil automático —por ejemplo, ydata-profiling o Sweetviz— ayuda a detectar patrones iniciales, no reemplaza la validación del significado. Revisa tamaño, tiempo de ejecución, sensibilidad de los datos y compatibilidad con las versiones del proyecto antes de agregarlo como dependencia.
Mira las distribuciones y las relaciones
import matplotlib.pyplot as plt
import seaborn as sns

sns.histplot(data=df, x="monthly_charges", hue="churn", stat="density", common_norm=False)
plt.title("Cargos mensuales por estado de churn")
plt.show()

sns.pairplot(df[["tenure", "monthly_charges", "total_charges", "churn"]], hue="churn")
plt.show()
Los histogramas muestran forma, asimetría y concentraciones. pairplot compara pares numéricos; una matriz de correlación resume asociaciones lineales, pero no demuestra causalidad ni descubre toda relación no lineal. Los heatmaps son un resumen, no una explicación: valida sus patrones con gráficos y conocimiento del dominio.
9.3 Datos faltantes: estrategia según mecanismo y uso
No todo NaN significa lo mismo:
| Patrón | Intuición | Ejemplo | Riesgo |
|---|---|---|---|
| MCAR | Ausencia independiente de los valores y del grupo | Se perdió una fila por una falla aleatoria | Puede reducir potencia y sesgar si no es realmente aleatorio |
| MAR | La ausencia depende de variables observadas | Ingresos faltan más en una región registrada | Puede modelarse condicionando en esas variables |
| MNAR | La ausencia depende del valor no observado | Usuarios con deuda alta omiten la respuesta | Imputar con una mediana puede ocultar precisamente la señal |
El mecanismo no siempre puede demostrarse solo con el dataset. Cruza indicadores de ausencia con variables disponibles y consulta cómo se generó la información.
- Eliminar filas: razonable si son pocas, la pérdida no introduce sesgo y queda documentada.
- Imputar mediana/moda: baseline robusto para una primera solución; aprende solo en train.
- Imputar con grupo: útil si hay una regla de negocio defendible; el grupo debe conocerse al predecir.
- Indicador de ausencia: conserva la señal de que faltaba el dato, cuando esa ausencia puede ser informativa.
- Imputación avanzada: KNN o modelos múltiples pueden ser apropiados, pero añaden supuestos y costo; no garantizan menos sesgo.
9.4 Outliers: validar, explicar y recién después tratar
Un extremo puede ser un error (edad = 900), una unidad mal interpretada (centavos como dólares) o un caso real importante (una transacción de alto valor). Un boxplot o el rango intercuartílico (IQR) marca candidatos, no autoriza borrarlos.
Para IQR, Q1 − 1.5 × IQR y Q3 + 1.5 × IQR son límites de exploración. Considera, en este orden:
- Validar reglas físicas y de negocio.
- Corregir unidades o parseo si existe evidencia.
- Mantener el valor si es real y relevante.
- Usar una transformación robusta o limitar el efecto solo con criterio documentado.
- Comparar resultados con y sin el tratamiento en validación, no en el test final.
RobustScaler usa mediana y rango intercuartílico; reduce la sensibilidad de la escala, pero no convierte un dato incorrecto en válido. Los límites deben aprenderse dentro del pipeline de entrenamiento.
9.5 Escalado, codificación y PCA
Modelos basados en distancias o gradientes suelen ser sensibles a la escala. Las categorías necesitan codificación adecuada; un identificador como customer_id normalmente se excluye, porque sus números no representan magnitud.
| Transformación | Qué hace | Cuándo considerar |
|---|---|---|
StandardScaler | Centra en media y divide por desviación estándar | Regresión logística, SVM, PCA y distancias; sensible a extremos |
RobustScaler | Centra en mediana y escala por IQR | Variables con extremos reales que no conviene recortar |
OneHotEncoder | Crea indicadores por categoría | Categorías sin orden natural |
OrdinalEncoder | Asigna códigos ordenados | Solo cuando el orden tiene significado y se modela explícitamente |
| PCA | Proyecta sobre componentes ortogonales de máxima varianza | Reducir dimensionalidad de variables numéricas escaladas; no explica causalidad |
PCA produce combinaciones lineales de variables. La varianza explicada mide dispersión capturada, no importancia de negocio ni información predictiva garantizada. Ajusta escalador y PCA dentro de train o de cada fold.
from sklearn.decomposition import PCA
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

pca_numerico = Pipeline([
    ("escala", StandardScaler()),
    ("pca", PCA(n_components=0.95)),
])

# pca_numerico.fit(X_train_numerico)
# X_train_reducido = pca_numerico.transform(X_train_numerico)
# X_validacion_reducida = pca_numerico.transform(X_validacion_numerico)
9.6 Ingeniería de features y transformadores
Una feature debería representar una hipótesis explicable. Para churn, por ejemplo, cargos_mensuales / antiguedad puede aproximar una presión de costo relativa, pero hay que manejar antigüedad cero y comprobar que el cálculo tenga sentido para la decisión.
Cuando un cálculo es parte del preprocesamiento, conviene encapsularlo para que entrenamiento y predicción apliquen exactamente la misma regla:
import numpy as np
from sklearn.base import BaseEstimator, TransformerMixin

class CargosPorAntiguedad(BaseEstimator, TransformerMixin):
    def fit(self, X, y=None):
        return self

    def transform(self, X):
        values = X.to_numpy() if hasattr(X, "to_numpy") else X
        cargos = values[:, 0].astype(float)
        meses = values[:, 1].astype(float)
        return (cargos / np.maximum(meses, 1)).reshape(-1, 1)

    def get_feature_names_out(self, input_features=None):
        return np.array(["cargos_por_mes_de_antiguedad"], dtype=object)
El transformador no aprende estadísticas, por eso fit solo devuelve la instancia. Si la transformación estima umbrales, promedios, categorías o parámetros, debe aprenderlos en fit y reutilizarlos en transform.
9.7 Pipeline y ColumnTransformer: una receta sin fuga
El siguiente ejemplo trabaja con columnas de clientes. Sustituye los nombres por los del dataset y excluye identificadores y el target de X.
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder, StandardScaler

numeric_features = ["SeniorCitizen", "TotalCharges"]
categorical_features = ["Contract", "InternetService"]

numeric_pipeline = Pipeline([
    ("imputer", SimpleImputer(strategy="median", add_indicator=True)),
    ("scaler", StandardScaler()),
])

categorical_pipeline = Pipeline([
    ("imputer", SimpleImputer(strategy="most_frequent")),
    ("one_hot", OneHotEncoder(handle_unknown="ignore")),
])

preprocessor = ColumnTransformer([
    ("numeric", numeric_pipeline, numeric_features),
    ("categorical", categorical_pipeline, categorical_features),
    ("derived", CargosPorAntiguedad(), ["MonthlyCharges", "tenure"]),
], remainder="drop")
ColumnTransformer aplica una rama por tipo de columna; el Pipeline interno conserva el orden entre imputación y escalado. handle_unknown="ignore" evita fallar por una categoría nueva, pero no reemplaza el monitoreo de categorías desconocidas.
No calcules imputaciones, escalas, categorías frecuentes, selección de variables ni componentes PCA con todo el dataset antes de separar entrenamiento y prueba. Incluye las transformaciones aprendibles en el pipeline y ajusta con X_train.
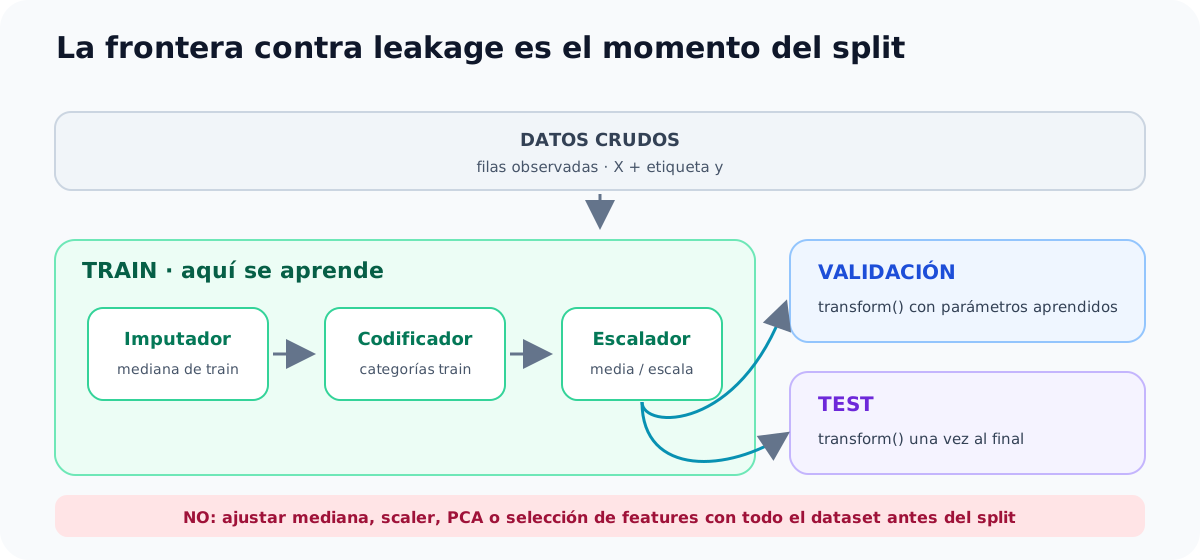
transform. Así evitamos que información de evaluación influya en el preprocesamiento.9.8 Errores comunes y verificación
Con el CSV Titanic de la pre-entrega local M9, clasifica columnas por tipo, mide faltantes y duplicados, inspecciona distribuciones de Age y Fare, y justifica qué hacer con Cabin, Embarked y extremos de tarifa. Después construye las ramas numérica y categórica en un ColumnTransformer, divide antes de ajustar y comprueba que el pipeline prediga filas nuevas con una categoría no vista.
💡 Piensa en qué conjunto aprende la mediana y la escala.
Q: ¿Cuándo elegirías PCA y qué precaución aplicarías?
Lo evaluaría para reducir variables numéricas correlacionadas o costo de cómputo, después de escalar. Lo ajustaría dentro de cada fold de entrenamiento y revisaría si la reducción conserva desempeño y utilidad interpretativa.
🪤 Decir que los componentes principales son las variables más importantes o que explican causalidad.Para continuar
M9 convierte datos heterogéneos en entradas consistentes. En M10 usarás esas transformaciones dentro del entrenamiento, compararás modelos y elegirás métricas según el costo real de cada error.
Tu espacio de estudio
Notas privadas
Se guardan solo en este navegador y no se publican.